Demandez à la plupart des développeurs de « bloquer le robot d’IA » et ils ajoutent une ligne dans robots.txt, comme si OpenAI ne faisait tourner qu’un seul robot. Il en fait tourner quatre, et chacun fait un travail différent. Bloquez le mauvais, et rien ne casse, aucune erreur n’apparaît nulle part — votre entreprise arrête simplement, en silence, d’être la réponse que donne ChatGPT, et vous ne saurez jamais pourquoi. C’est tout le cœur pratique du SEO pour ChatGPT : pas de nouvelles astuces, seulement savoir lequel des quatre robots d’OpenAI vous touchez réellement quand vous modifiez ce fichier. Pour la vue d’ensemble — comment ChatGPT se compare aux AI Overviews de Google, à Perplexity et au reste, chiffres à l’appui pour chacun — le portrait complet est ici. Ce texte reste plus étroit, et plus facile à corriger : un seul réglage, à vérifier aujourd’hui.
OpenAI fait tourner quatre robots, et un seul décide si vous apparaissez
La documentation officielle pour développeurs d’OpenAI recense quatre user-agents distincts, chacun avec un rôle précis :
- OAI-SearchBot — fait apparaître des sites web dans les réponses de recherche de ChatGPT.
- GPTBot — explore le contenu pour entraîner le modèle sous-jacent.
- ChatGPT-User — visite une page en réponse à une action qu’une personne a demandée à ChatGPT ou à un GPT personnalisé ; OpenAI précise que « parce que ces actions sont déclenchées par un utilisateur, les règles de robots.txt peuvent ne pas s’appliquer ».
- OAI-AdsBot — vérifie la sécurité des pages soumises comme publicités dans ChatGPT.
OpenAI résume la distinction en une phrase, et elle vaut la peine d’être citée mot pour mot : « un webmestre peut autoriser OAI-SearchBot pour apparaître dans les résultats de recherche tout en bloquant GPTBot pour indiquer que le contenu exploré ne doit pas servir à l’entraînement ». Bloquez GPTBot, et votre contenu reste hors du futur entraînement du modèle — un choix légitime, sans aucun effet sur le fait que ChatGPT vous cite demain ou non. Bloquez OAI-SearchBot, et l’effet joue dans l’autre sens : OpenAI affirme sans détour que les sites qui excluent OAI-SearchBot « ne seront pas montrés dans les réponses de recherche de ChatGPT », même s’ils « peuvent encore apparaître comme liens de navigation ». La plupart des conseils du type « bloquez les robots d’IA » traitent GPTBot comme s’il résumait tout, parce que c’est l’entraînement qui inquiète les gens. C’est justement le seul robot qui n’a rien à voir avec le fait d’être cité.
La même distinction existe chez Anthropic et Meta — différemment chez Perplexity
Ce n’est pas une particularité d’OpenAI. Anthropic fait tourner trois robots : ClaudeBot entraîne le modèle, Claude-User récupère une page en réponse à une question posée en direct, et Claude-SearchBot gère l’indexation pour les réponses de type recherche. Meta répartit les deux mêmes rôles entre Meta-WebIndexer, le robot qui, selon l’entreprise, permet à Meta AI de « citer votre contenu et d’y renvoyer par un lien », et Meta-ExternalAgent, qui explore le contenu pour entraîner les modèles de fondation.
Perplexity structure la chose autrement, et cette différence est révélatrice. PerplexityBot fait apparaître votre site et y renvoie par un lien dans les réponses de Perplexity ; Perplexity-User récupère une page qu’une personne a réellement cliquée. Il n’existe carrément pas de troisième robot pour l’entraînement — l’entreprise le dit directement : « Perplexity ne construit pas de modèles de fondation, votre contenu ne sera donc pas utilisé pour le pré-entraînement des modèles d’IA ». Quatre entreprises, et une seule — Perplexity — se passe complètement du robot d’entraînement. OpenAI, Anthropic et Meta tracent tous la même ligne : entraînement et citation, deux robots qu’on peut bloquer séparément.
Sur son propre terrain, Google maintient lui aussi ces deux questions séparées, pour ce que ça vaut : Google-Extended régit l’entraînement et les données de grounding pour Gemini et Vertex AI, et n’a rien à voir avec l’apparition d’une page dans les AI Overviews. Ce réglage a son propre contrôle dans Search Console, que Google a déployé sur tous les sites le 31 août 2026, et contrairement aux balises d’extraits à côté desquelles il se trouve, ce contrôle ne touche pas aux résultats de recherche ordinaires — notre article sur ce qui contrôle vraiment les AI Overviews passe en revue les deux. Traitez chaque robot dont le nom contient « IA » comme une seule ligne à bloquer, et vous répondez aux deux questions avec une seule règle, que ce soit voulu ou non.
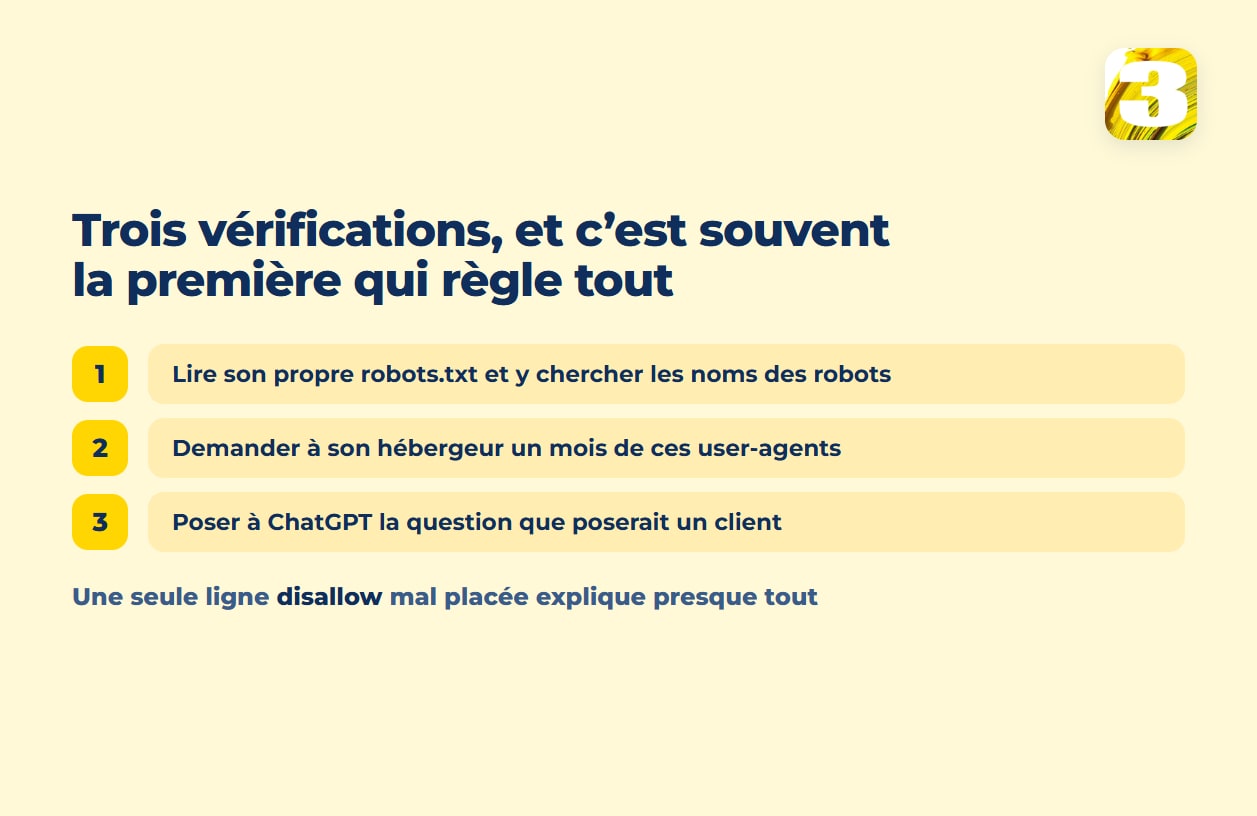
Le test SEO de vingt minutes pour ChatGPT
La première et la troisième étape ne demandent aucun outil et prennent quelques minutes chacune. La deuxième demande quelqu’un qui a accès au serveur, donc la réponse revient quand votre hébergeur répond, pas pendant que vous attendez.
Ouvrez votre propre robots.txt (votresite.com/robots.txt) et cherchez les chaînes exactes — OAI-SearchBot, GPTBot, ChatGPT-User, et les équivalents pour tout autre système d’IA qui vous importe. La plupart des sites n’ont aucune ligne pour ces noms, ce qui veut dire que chacun de ces robots est déjà bienvenu par défaut. Si un Disallow: / se trouve sous l’un des noms tournés vers la recherche — OAI-SearchBot, Claude-SearchBot, Meta-WebIndexer, PerplexityBot — c’est celui-là qui vous bloque réellement. La répartition que la plupart des propriétaires de site souhaitent réellement ressemble à ceci :
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
Hors de l’entraînement, toujours dans les réponses. Si le fichier dit actuellement l’inverse, la correction tient en une ligne, et quiconque a déployé votre site peut la faire — c’est un simple fichier texte à la racine, pas une modification de code.
Demandez à qui gère votre serveur les visites de ces mêmes user-agents sur le dernier mois — un ticket de support auprès de l’hébergeur suffit habituellement, et la question tient en une phrase. Un site qui reçoit du trafic se fait normalement explorer, donc un mois à zéro mérite une explication. Souvent, ça veut dire qu’un blocage silencieux se produit avant même robots.txt — un plugin de sécurité ou un pare-feu au niveau de l’hébergement qui refuse la requête avant même que le fichier soit lu. Ça peut aussi vouloir dire quelque chose de plus banal : des journaux qui n’enregistrent pas les user-agents, ou une fenêtre de conservation plus courte que la période demandée.
Ouvrez ChatGPT et posez-lui les trois questions qu’un vrai client taperait — la vraie question sur le service, pas le nom de votre marque — et notez qui il nomme. Si la réponse n’est pas vous, ce n’est pas un problème de robots.txt. C’est exactement la question à laquelle notre travail de SEO local est conçu pour répondre, parce qu’une question de service à laquelle ChatGPT répond et la même question à laquelle répond un pack de résultats locaux sur la carte s’appuient largement sur le même ensemble de faits sur une entreprise — ce que vous faites, où, ce que vous chargez, ce que les anciens clients ont dit.
Pourquoi votre SEO pour ChatGPT ne se lit pas sur un tableau de bord
Où le trafic issu de l’IA apparaît — et n’apparaît pas — dans les analyses est une histoire plus longue, et l’article pilier la raconte en entier. Deux éléments sont plus récents que cet article et méritent d’être clairs, parce qu’on les confond constamment.
Un clic venu d’un AI Overview n’est pas perdu — il atterrit dans le rapport global de performance de Search avec tous les autres clics, simplement sans étiquette qui le distingue du reste. Ce que Google ne vous donne pas, c’est une lecture séparée : le rapport de Search Console conçu spécifiquement pour les fonctionnalités d’IA générative vous remet seulement des impressions, aucun taux de clics, et il n’isole pas les AI Overviews du mode IA — les deux sont comptés ensemble.
Rien de tout ça ne veut dire que ce trafic n’est pas réel. Ça veut dire que n’importe quelle étiquette de canal le sous-comptera. C’est pourquoi nous ne travaillons pas seulement à partir de l’étiquette : notre propre extension de suivi des demandes est installée sur les sites que nous construisons, et les demandes venues via ChatGPT y apparaissent comme une ligne visible plutôt qu’une supposition enfouie dans « Direct ». Ce n’est pas un chiffre que nous pouvons publier, et nous ne prétendrons pas le contraire — mais c’est la différence entre savoir que le canal existe et supposer qu’il n’existe pas.
Demandez-nous ce que votre robots.txt dit vraiment aux robots d’IA